这是《AI知识库搭建实战》系列的第一篇。这个系列会从「为什么需要知识库」讲起,一路讲到 Obsidian 搭建、切片向量化、工具选型、企业落地和进阶玩法。今天先把地基打牢:你的知识库,到底为什么用不起来。
先说个我自己的场景。
我微信收藏夹里有三百多篇没看的文章,Obsidian 里躺着两千多条笔记。上周想找一篇讲 RAG 检索优化的文章,我记得标题里有 Rerank 三个字母,于是在收藏夹、笔记库、聊天记录里翻了快十分钟,愣是没找到。最后是在一个公众号的往期推送里捞出来的。
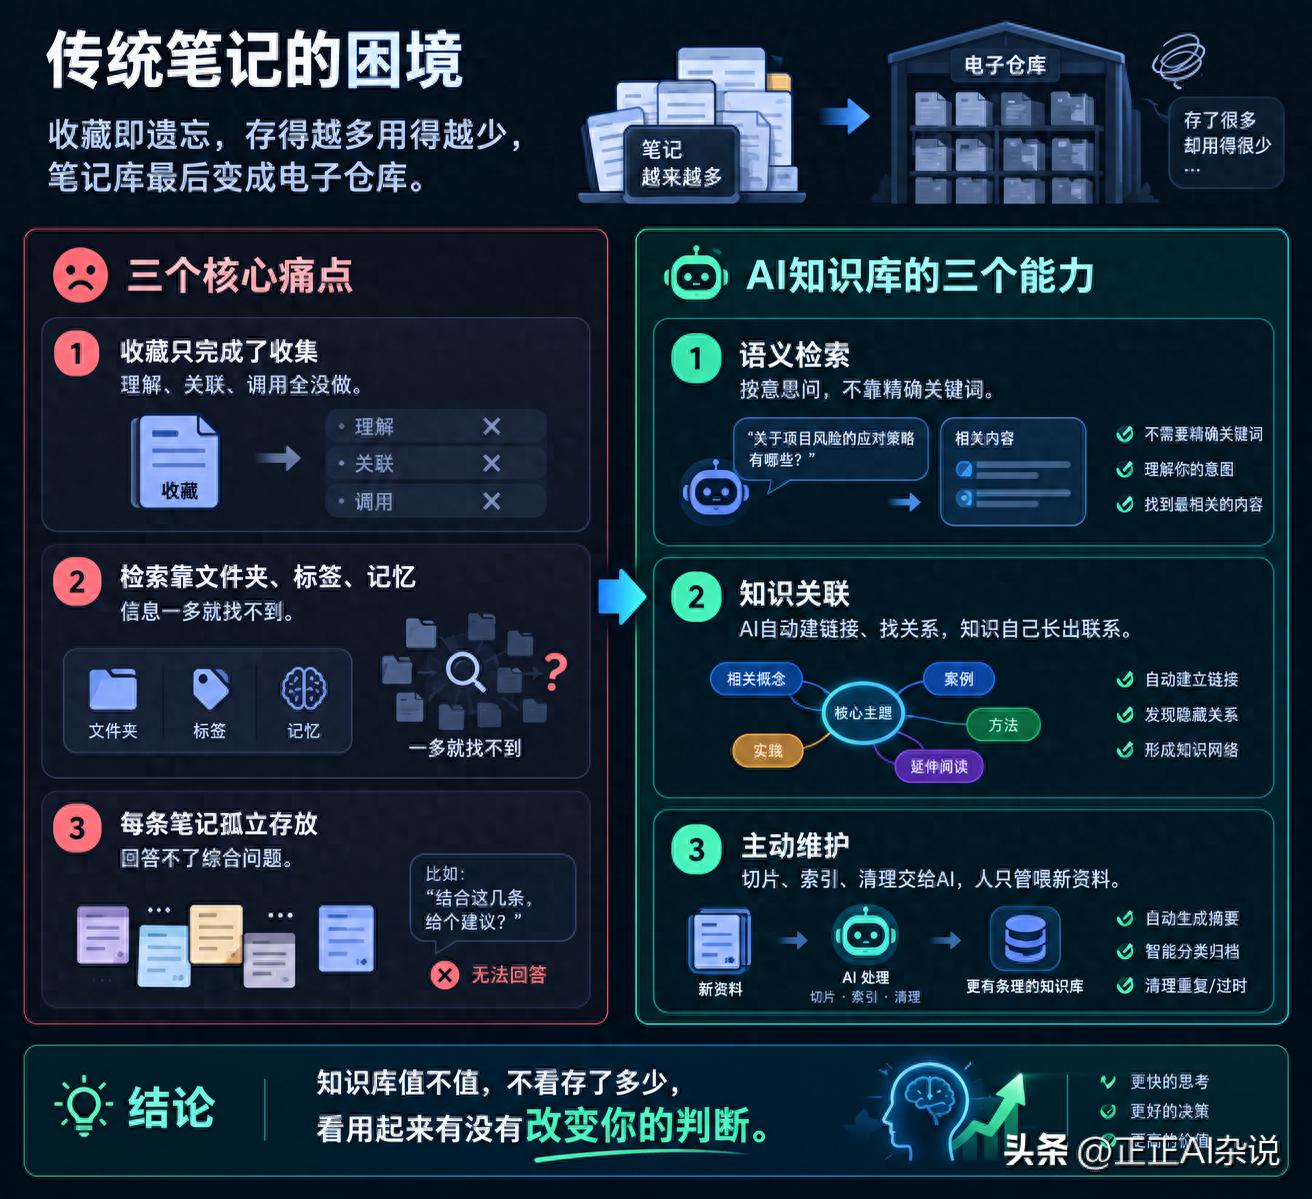
存的时候想的是「以后用得上」,可真到用的时候,手里明明有几千条「以后用得上的东西」,一条都摸不着。收藏即遗忘,这是传统笔记最扎心的病。
收藏按钮按下去的那一秒,就是这条内容的终点
很多人以为收藏等于拥有,其实恰恰相反。收藏是这条内容最后一次被你认真对待的时刻,从那一刻起,它就开始在角落里积灰。
一条信息真正变成知识,至少要经过四步:收集、理解、关联、调用。收藏只完成了第一步。我们收藏夹里的绝大多数内容,永远停在了第一步。
我见过最典型的翻车现场是这样的:老板问「咱们去年双十一的复盘在哪」,你打开笔记库,文件夹几十个,标签几百个,翻了五分钟没找到,最后从聊天记录里捞出当时的会议纪要,重新读一遍才想起来。内容不是没有,是你根本不知道它躺在哪。
你的笔记库,最后怎么变成了电子仓库?
我自己的知识管理进化史,基本就是一部仓库膨胀史。
最早用 Evernote,看到好文章就剪藏,几年攒了上千条。后来发现剪藏的东西再也没打开过,就换到 Obsidian,觉得本地+双链+标签肯定不一样。结果呢?第一周很勤奋,给每条笔记打标签、建文件夹,过俩月忘了该往哪儿归,又新建文件夹。文件夹越来越多,标签越打越乱,最后连我自己都懒得翻了。
这不怪工具,怪我把「存」当成了「用」。知识库的重点不是保存,是调用。你把食材全买回家,不洗不切不炒,冰箱塞得再满,吃饭的时候还是只能点外卖。
检索靠运气这件事,根本无解
传统笔记找东西靠三样:文件夹、标签、记忆。单个用还行,合起来就是灾难。
文件少的时候没问题,几十条笔记,翻就翻到了。可一旦上千条,靠目录结构根本管不过来——你永远猜不到自己三个月前把那条笔记归到了哪个文件夹。靠记忆更不靠谱,你连存过什么都想不起来,怎么搜?
很多研发团队也是这样。文档越来越多,版本越叠越厚,可知识反而在流失。老制度发布新版本,旧版没过期也没标失效,检索的时候旧版更短更直接,排在最前面。人拿着旧版去干活,答案自然跑偏。这不是检索技术的问题,是知识本身没人管、没标记、没治理。
单条笔记回答不了综合问题,AI可以。传统笔记每条都是孤岛,你想查「上个月客户续费到底打几折」,得自己翻销售制度、客户等级规则、最新政策三份文档,再自己拼。拼的过程中漏一条,结论就错了。
AI知识库和传统笔记,差在哪?
AI 知识库的第一个变化在检索:不用精确关键词,按意思问就行。
以前找「上次讨论的降价方案」,你得记得确切词条。现在你直接问「上次跟销售聊那个把价格降下来的方案」,AI 能理解你的意思,去库里找出相关的会议纪要、方案文档,把要点列给你。它看得懂上下文,而不是死板地匹配字符。
检索到了,还要排得准。库里几百条相关内容,哪条最该被用上?RAG 系统里专门有一层叫 Rerank,就是把第一次粗筛出来的结果重新精排,让最相关的排前面。这一层做不做,答案质量差一大截。
真正的变化在这:知识自己会长出联系
检索只是表象,AI 知识库真正不一样的是关联。
传统笔记库里,两条笔记除非你手动建双链,否则永远是两条独立的内容。AI 不一样,它会自动识别文件之间的关联:这篇提到的方法,和那篇的案例是同一个问题;这条记的错误,和另一条规则是同一个坑。反向链接、时间线、孤立页面检查,这些以前要你手工梳理的活,AI 自己就能干。
所以现在大家开始换方向了。过去十几年,所有人都在劝你给自己建「第二大脑」:把看过的全存下来,分类打标签建双链,整理得漂漂亮亮。可结果是,大多数人坚持不了维护,第二大脑变成了装修精美的电子仓库。
给 AI 建第二大脑,才是这一站。AI 不怕资料多,多多益善,它会自己整理、自己找、自己判断该留什么。你要做的只有一件事:把新资料喂进去。人从「天天打扫仓库」里脱身出来,知识库才真正好用。
维护的活交给AI,其实你只管喂就行
我把这套事理顺之后,最大的感受是分工变了。
以前是我负责收集、分类、打标签、建关联,AI 负责读。现在是 AI 负责切片、向量化、更新索引、查孤立页、修复过期链接,我负责往里喂。基础维护很多是脚本活,不需要烧大模型 token,成本也不高。
企业里道理一样,只是规模更大。一个真正能用的企业知识库,不是上传文件建个索引就完事,而是一条长期运行的知识供应链:从业务系统进来,经过解析清洗变成正式知识,配上版本、权限、有效期,被应用和 Agent 调用,再根据使用数据持续修正。构建、治理、使用、优化,四件事循环起来,知识才不会烂在库里。
别全交出去:筛选和审核得自己守
说了这么多,别急着把所有东西都丢给 AI。有两个环节,人必须自己守。
一是信息筛选。什么内容配进你的知识库,这是质量的源头。收藏那些别人写得再好但跟你业务无关的文章,只会污染库里的判断。进库之前先问自己:这是我确认过的信息吗?它以后解决什么问题?我敢不敢拿着它做决策?
二是审核。AI 生成的摘要、整理的结构,你真的要看一遍。别全自动跑完就散手,那是把判断权也交出去了。低成本维护、高质量知识、个人内化,三者最多取其二,想清楚你优先要哪个。

发表评论 取消回复