这是 AI 编程系列这组文章里我个人的收官篇。前面几篇聊了工具怎么选、Vibe Coding 的正确姿势、返工为什么总发生,还有架构设计和团队协作。这篇换个角度,说说我们跟 AI 一起写代码这件事,正在往哪个方向走。
我不做预测。只是把自己这一年多的使用方式摆出来看,发现变化比我以为的快。
我这一年用 AI 写代码的方式,变了三次
最早那阵子,我用的是补全。写下函数名,它帮我续两行,剩下的我自己来。那会儿的判断标准很简单:它猜得准不准。
后来变成交代任务。我在 Codex 里把一段需求说清楚,它给我一个能跑的模块,我跑一遍,不对就指出来让它改。判断标准变成了:它能不能一次做到位。
再往后,我开始把整件事丢出去。我那套内容管线就是这样,早上七点自己爬起来采集、分析、推送,中间没人在旁边盯着,它自己走完。这时候判断标准又变了:出了问题,兜不兜得住。
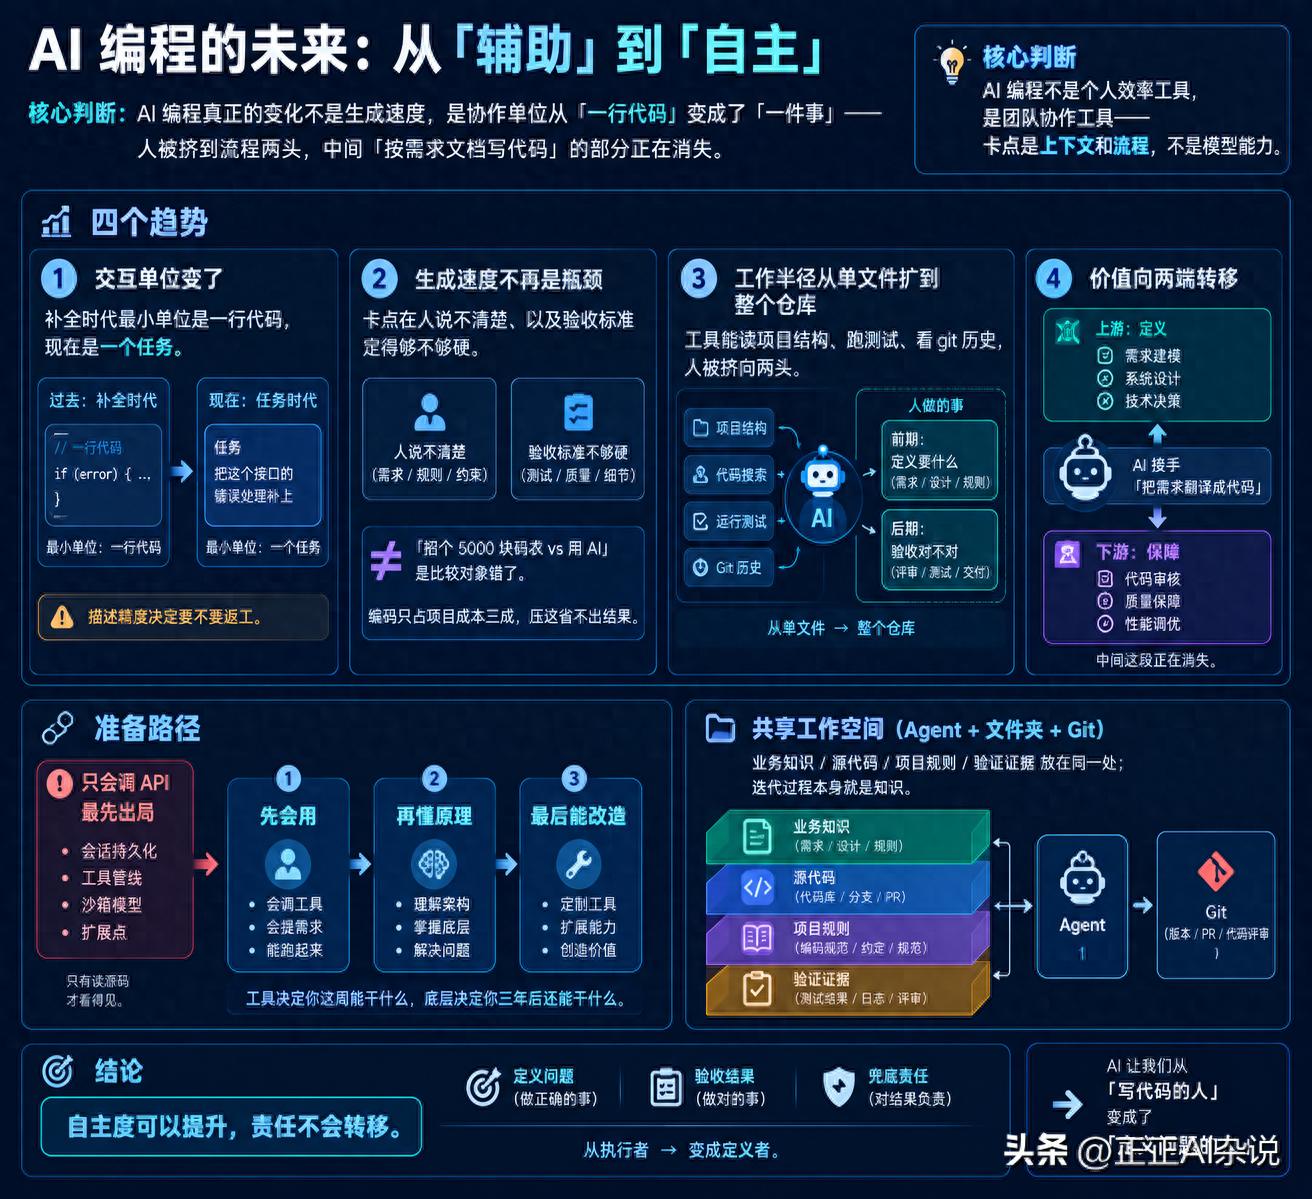
补全、交代任务、丢出去,三个阶段看着像工具在变强,其实是同一件事在变——我在流程里的位置,一点点往后挪。以前我在链条中间拧螺丝,现在我在两头:前面交代要什么,后面检查对不对。
其实交互的单位早就变了
补全时代,人和 AI 之间的最小单位是一行代码。Tab 按下去,吐出来一整行。
现在不是了。现在的单位是一个任务。你说的是「把这个接口的错误处理补上」「把这三段重复逻辑抽成一个函数」「这个页面加载慢,你去查一下」——你要的是结果,不是哪一行代码。
单位变了,对人的要求跟着变。补全时代手速快、记得住 API 就占优势;任务时代,能不能把话说明白成了第一道门槛。同一句需求,说得含糊和说得具体,出来的东西完全是两码事。我在写 Vibe Coding 那篇时提过一句:反馈速率就是你的速度上限。这里再加一句——描述的精度,决定你要不要返工。
这不是模型变聪明那么简单,而是协作的单位从一行代码换成了一个任务。单位换了,标准自然也得跟着换。
但真正拉开差距的,不是生成速度
我见过不少人还在比生成速度:谁家模型一秒吐多少 token,谁家补全更顺滑。
这个比较撑不了多久。生成速度早就不是瓶颈,我现在的卡点从来不是它写得慢,是我说不清楚,或者它做的不是我要的那个东西。慢的那一环在我这边。
前阵子朋友转给我一段群聊,一个老板在里面问:现在招个码农才五千块,用 AI 还得烧 token,那我上什么 AI?这话听着有道理,但比较对象选错了。五千块招来的人干的是填空式的编码执行——简单的增删改查、页面样式调整、照着模板复制粘贴。
而一个真实项目的成本里,需求理解、方案设计、接口对接、性能优化、上线运维这些加起来占七成以上,纯粹的写代码不到三成。你把那三成从两万压到五千,省了一万五,另外七成纹丝不动,甚至因为经验不足,返工和沟通成本还要往上走。
说到底,AI 替代的从来不是程序员,是「编码这个动作」。这个动作恰好是你以为能省掉、其实省不掉的那部分里最便宜的一段。
工作半径从文件扩到整个仓库
以前的 AI 编程工具只看得见你打开的那个文件。现在它看得见整个项目:目录结构、依赖、测试、git 历史,甚至能自己跑一遍测试看结果。
这个半径的扩大,改变的是分工。我在讲工具选型那篇里说过,第一步是让它先读项目,别急着让它写。当时这是个技巧,现在更像是默认动作——因为工具确实读得懂,你拦着它反而亏。
但半径变大之后,人的位置被挤到了两头。中间那段「看需求、翻译成代码」的活,它干得比我快,也比我稳定。我这一年里的真实体感是:花在写代码上的时间少了,花在「定义什么叫做完」上的时间多了。
我现在的做法是,先让它把项目结构、测试怎么跑、哪些文件是历史包袱都摸一遍,再让它动手。有一次我图快,跳过这步直接让它改脚本,改完跑通了,但把一个只在特定分支才用的旧逻辑删了——那段逻辑藏在另一个目录里,它没读到。真正的成本不在它写错,在你没让它看清楚。
这个变化一开始挺不舒服的。你会有种被架空的感觉——活还是那些活,但你在链条上的位置换了。
为什么「只会调 API」最先出局?
我自己的判断是,最先感受到压力的,是只会调 API 的那批人。
这类人的典型状态是:照着官方文档,把 Demo 跑通没问题;一旦要改底层、做二次开发、或者自研一套,立刻卡住。会话状态怎么持久化、工具调用的完整管线怎么流转、沙箱的权限模型怎么设计、插件扩展点埋在哪,这些问题在 README 和使用教程里找不到答案。
我改自己那套自动化管线时就踩过这个坑。早期我是照着文档改配置,改到某个地方怎么都不对,翻了两小时文档没用,最后去读源码,才发现那个参数在运行时会被另一个配置覆盖掉——文档里根本没写这件事。
这不是说文档没用,而是说文档教的是「怎么用」,源码才教「为什么这么设计」。前者随着版本更新会失效,后者不会。
别急着学新框架,先补底层那课
我知道这话有点反直觉。工具更新这么快,不去追新框架,不怕被落下吗?
我的判断正好相反:框架换得越快,底层知识越值钱。你今年学的框架明年可能没人用,但「一个 Agent 运行时需要哪些组件、为什么需要」这些认知是能迁移的。
最近看到一个开源的 Agent 源码拆解课程,收了五套项目:一套极简的终端编码 Agent、一套插件化的 Harness、一套真实生产环境打磨的自进化 Agent,还有两套从零手写实现的路线。作者把源码逐段拆开讲设计动机,不只是告诉你这段代码在干什么,还告诉你为什么这么写。
我的建议是照着它那个顺序来:先会用,再懂原理,最后能改造。多数人卡在第一步就停下了,但真正拉开差距的是第二步——你能不能看懂别人为什么这么设计。
工具和底层的收益曲线也不一样。学工具决定你这周能干什么,学底层决定你三年后还能干什么。关键在于,工具会换,底层不会——我现在改脚本踩的那些坑,几乎都能追到同一个原因:只知道怎么调,不知道它内部是怎么串起来的。
人往两端走,中间那段被吃掉了
把上面几条串起来,就是我对未来的判断:程序员的活会往两端集中。
上游是需求分析、业务建模、系统设计、技术决策。这部分 AI 替代不了,因为它的前提是「知道要什么」,而这件事只有身处业务里的人能回答。下游是代码审核、质量保障、运维自动化、性能调优。这部分 AI 能帮上忙,但判断权必须在人手里——它不知道自己错在哪。
真正在消失的是中间那段:按需求文档写代码。这段活的特征是「已经想清楚了」,剩下的只是翻译。翻译这个动作,AI 做得又快又好。
这个结构变化对个人其实是好消息。你不需要写出最漂亮的代码,但你需要学会把需求讲清楚、把验收标准定下来、把边界守死。这几件事不需要大厂资源,一个人就能开始练。
自主之后,人还剩下什么活?
如果趋势真的一路走到「我只描述需求,剩下的它自己完成」,那人的价值在哪?
我的答案是三件事:定义问题、验收结果、兜底责任。
定义问题,是指你得判断这件事值不值得做、做到什么程度算够。AI 不会告诉你「这个需求其实不该做」。验收结果,是指你得看得出它交付的东西是不是真的解决了问题——不是跑通了就算完,是边界情况、异常路径、后续可维护性都过得去。兜底责任,是指出了事得有人扛,这个人在流程图上永远是人。
自主度可以提升,责任不会转移。你让 Agent 跑得越自主,你越得把验收标准写得硬。这两件事是一起长的。
从执行者变成定义者,听起来像是升职,实际上要求更高了——以前你只要做对,现在你得说清楚什么算对。
下一篇不会再有了,这组文章到这里收尾。如果你也在用 AI 写代码,不妨回头看看自己这半年:你花时间的地方,是不是也在往两头挪。

发表评论 取消回复