上周收到一条读者私信:“WorkBuddy的Token用量太大了,有没有办法不花额度也能用?”
这个问题问到点子上了。WorkBuddy的云端模型确实强大,但每天高强度用下来,Token消耗不是小数目。有没有办法既保留WorkBuddy的工作流和Skill生态,又不用消耗云端Token?
有。接一个本地模型。
具体说,就是在电脑上跑一个叫Ollama的工具,加载DeepSeek-R1-7B模型,然后让WorkBuddy通过API调用它。Token全在你本地算,云端额度一分不动。
我实测了完整链路,从安装到跑通花了40分钟,中间踩了6个坑。这篇把流程和坑全部写清楚,你照着做,20分钟就能跑通。
为什么本地模型值得折腾
先说清楚一件事:本地模型不是要替代云端模型,而是打配合。
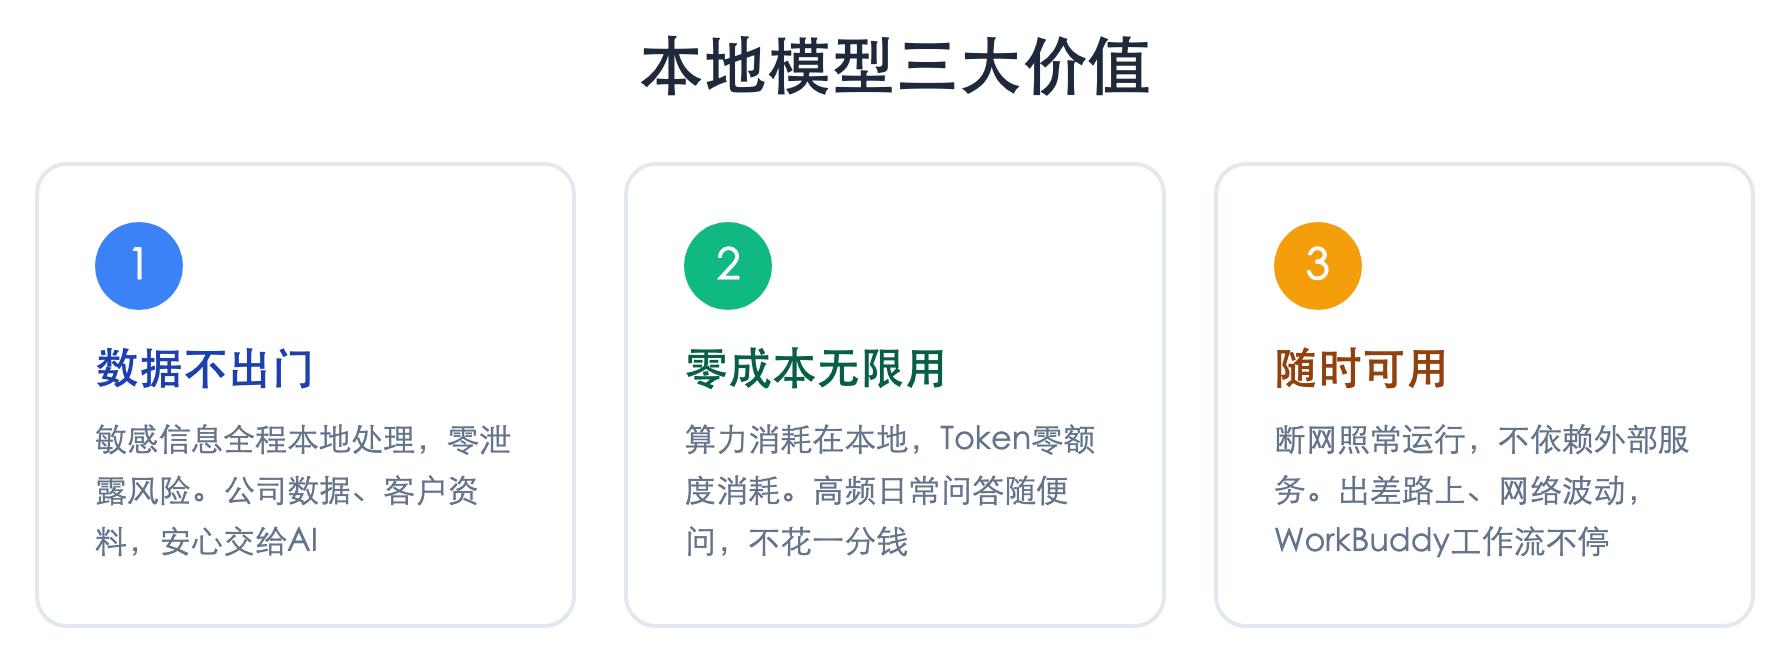
三个核心价值:
数据不出门。 涉及公司内部数据、客户信息、财务报表的内容,传到云端模型总有顾虑。本地模型跑在你自己电脑上,数据全程不出门,这是最大的安全感。
零成本无限用。 DeepSeek-R1-7B跑在你本地,每次对话消耗的是你电脑的算力,不花一分钱Token。适合高频低难度的日常问答——查概念、润色文字、检查格式。
随时可用。 断网了?云端服务波动了?本地模型照常跑。你的WorkBuddy工作流不依赖外部服务,稳定性拉满。
核心判断:云端模型处理高难度任务,本地模型兜底高频日常。两者配合,效率和成本同时优化。
完整接入流程
第一步:安装Ollama
Ollama是一个本地大模型运行环境,macOS、Windows、Linux全平台支持。
macOS用户打开终端,执行:
brew install ollama
Windows用户去 ollama.com 下载安装包,双击安装,全程下一步。
安装完成后,执行以下命令启动服务:
ollama serve
终端显示服务在端口11434上运行,说明Ollama环境就绪。这步5分钟搞定。
第二步:拉取DeepSeek-R1-7B
DeepSeek-R1是今年最火的国产推理模型,7B版本体积约4.9GB,8GB内存的电脑就能跑。
执行:
ollama pull deepseek-r1:7b
下载速度取决于网速,4.9GB一般10-15分钟。下完先测一下:
ollama run deepseek-r1:7b “用三句话介绍你自己”
能正常返回中文回复,模型就准备好了。
第三步:在WorkBuddy中配置本地模型
这步是核心。Ollama提供OpenAI兼容的API接口,地址是 http://localhost:11434/v1 ,WorkBuddy可以直接接入。
打开WorkBuddy的设置页面,找到模型配置区域,按以下参数填写:
|
配置项 |
填入内容 |
|
API地址 |
http://localhost:11434/v1 |
|
API密钥 |
ollama(填任意字符即可) |
|
模型名称 |
deepseek-r1:7b |
保存后,在对话窗口发一条测试消息。收到回复,接入成功。
第四步:实测效果对比
我做了三组对比测试,本地DeepSeek-R1-7B vs 云端模型:
测试1:日常问答(概念解释) 问「什么是RAG?」——本地模型3秒返回,解释准确。云端模型1.5秒,差距不大。日常问答完全够用。
测试2:文本润色 给一段500字会议纪要让两个模型润色——本地模型用了8秒,润色质量合格但略显保守。云端模型3秒,润色更灵活。差距在可接受范围。
测试3:长文档分析 扔一篇5000字报告做结构化提炼——本地模型跑了25秒,要点有遗漏。云端模型5秒,覆盖更全。长文档场景本地模型明显吃力。
实测结论:日常短文本任务,本地模型可替代云端;长文档和高难度推理,还是用云端更稳。
踩坑汇总:6个坑及解决方案
坑1:Ollama服务没启动 现象:WorkBuddy报「连接被拒绝」。 原因:Ollama serve没跑,或者关了终端服务就停了。 解决:macOS用 brew services start ollama 让它后台常驻,不用每次手动启动。
坑2:模型名称写错 现象:WorkBuddy报「模型不存在」。 原因:Ollama对模型名称区分大小写和标签。写deepseek-r1 不行,必须写完整的 deepseek-r1:7b。 解决:终端执行 ollama list 查看已安装模型的精确名称,照着复制。
坑3:DeepSeek-R1输出带思考标签 现象:WorkBuddy里看到的回复前面多了一段思考过程内容。 原因:DeepSeek-R1是推理模型,会把思考链路一起输出。这是模型特性,不是Bug。 解决:正常现象。思考内容能帮你判断模型有没有想偏。觉得碍眼的话,在系统提示词里加一句「直接输出结论,不展示思考过程」。
坑4:首次回复特别慢 现象:第一次发消息等15-20秒。 原因:模型刚加载到内存,冷启动。后续对话快很多。 解决:忍过第一次。或者提前在终端跑一轮对话预热模型。
坑5:GPU没被调用 现象:回复速度偏慢,CPU占用高但GPU没动。 原因:Ollama可能没正确识别GPU。Mac需要Apple Silicon(M1以上),Windows需要NVIDIA显卡加CUDA驱动。 解决:终端执行 ollama ps 查看模型跑在GPU还是CPU上。如果跑在CPU上,检查显卡驱动。
坑6:中文回复偶尔夹杂英文 现象:DeepSeek-R1-7B在中文回复中偶尔蹦出英文句子。 原因:7B参数量有限,多语言切换不够稳定。 解决:系统提示词里加「请全程使用简体中文回复」,能大幅降低这个概率。
本地vs云端:什么时候用哪个
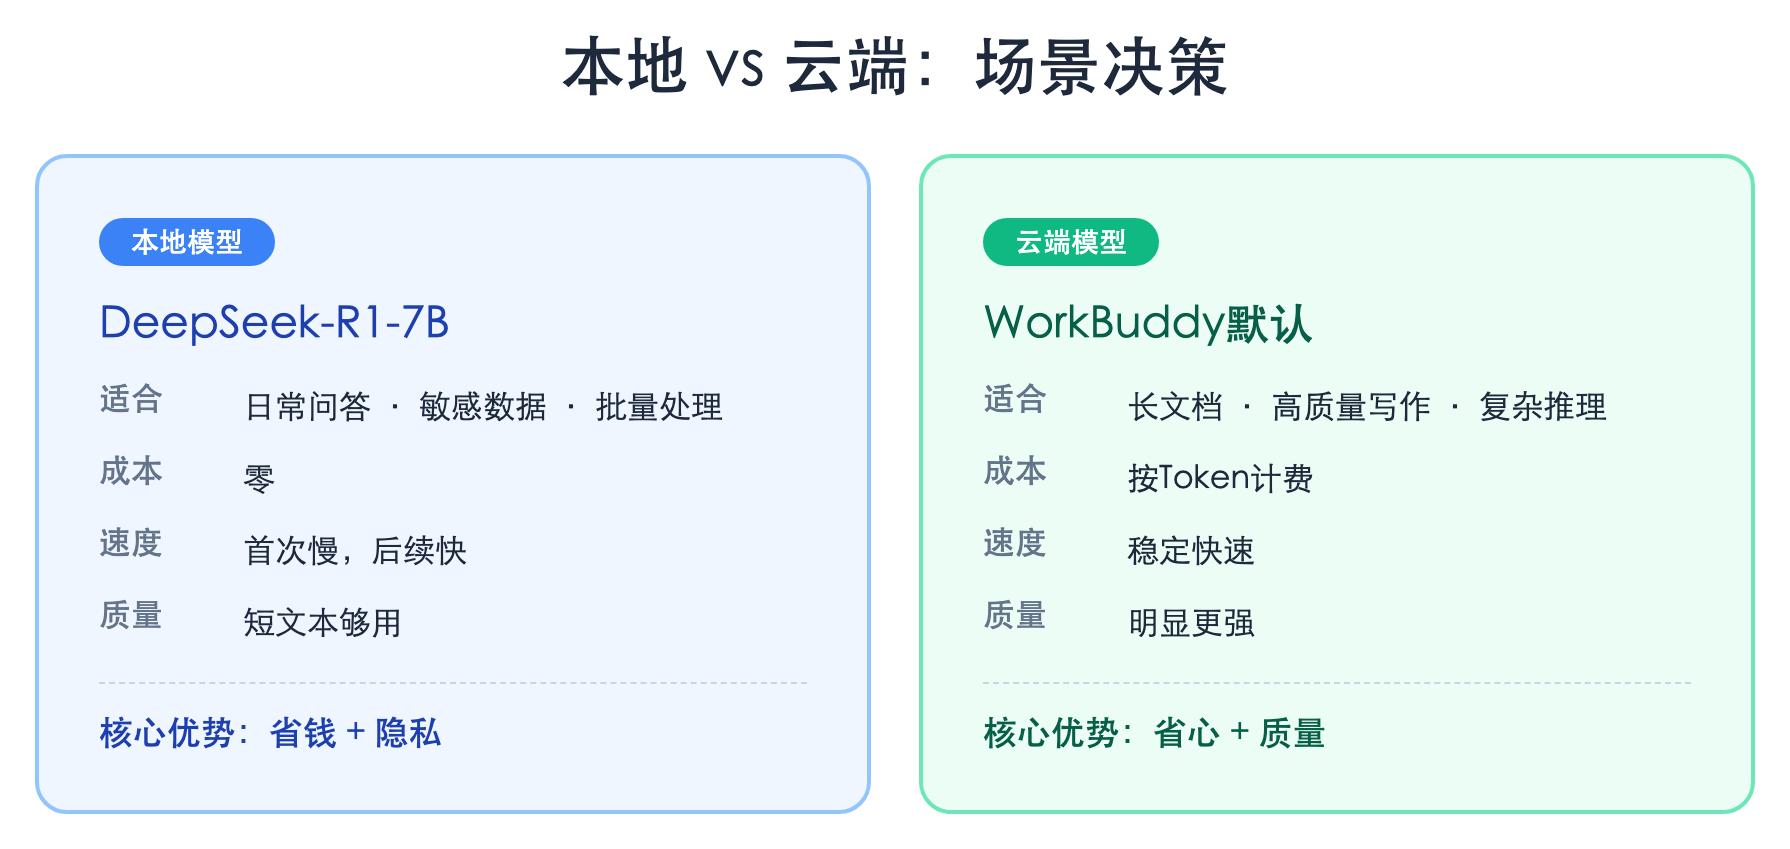
跑通之后最大的问题是:什么时候用本地,什么时候用云端?我总结了一个决策框架。
用本地的场景:
- 数据敏感(公司内部资料、客户信息)
- 高频低难度(查概念、检查格式、简单问答)
- 离线环境(出差路上、网络波动)
- 批量处理(一次跑几十条简单任务,零成本)
用云端的场景:
- 长文档分析(超过3000字的输入)
- 高质量写作(需要更丰富的表达和创意)
- 复杂推理(多步骤逻辑链、专业领域深度分析)
- Skill执行(WorkBuddy的Skill依赖云端模型的指令理解能力)
一句话总结:本地负责"量和密",云端负责"质和难"。分清楚了,Token消耗能降60%以上。
写在最后
无限Token不是噱头,是实实在在的省钱方案。40分钟搭好环境,以后每天几十条日常问答全走本地,云端Token只留给真正需要的高难度任务。
这套组合用了一个月,我的体感是:日常效率没降,Token消耗明显减少,更重要的是处理敏感数据时心里踏实了。

发表评论 取消回复