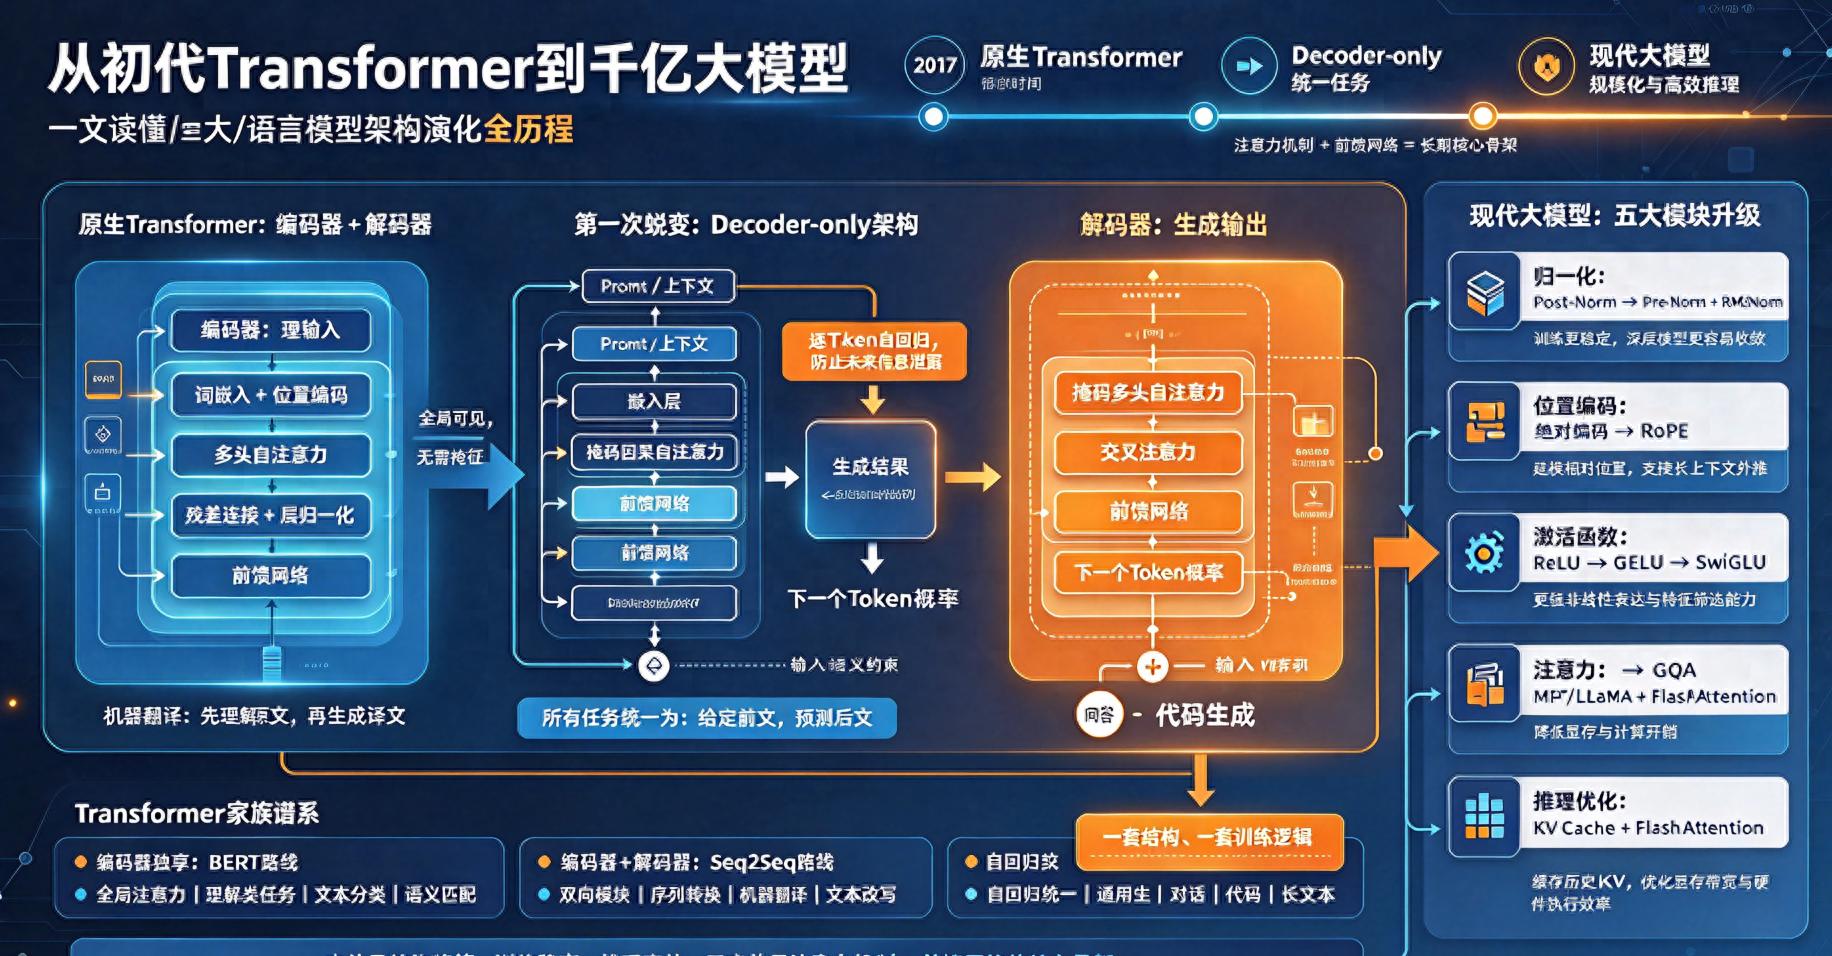
接触大语言模型的朋友大多都有过这样的疑惑,我们日常聊到的GPT、LLaMA、通义千问等主流大模型,核心架构都基于Transformer,但翻看2017年Transformer的原始论文架构图,会发现经典模型是编码器加解码器的双向结构,和如今大模型单一的解码器模块架构截然不同。
很多初学者会因此陷入困惑,到底哪种架构才是真正的Transformer,现代大模型是不是脱离了原始设计。其实答案很简单,所有主流大模型都没有跳出Transformer的核心框架,只是八年间经过多轮迭代优化,从最初专为机器翻译设计的原生架构,一步步精简、改造、升级,最终演化出了适配通用人工智能的现代大模型架构。
本文将顺着技术发展的真实脉络,拆解Transformer从原生架构到解码器独享架构,再到现代轻量化、高性能大模型的完整演化路径,理清每一次架构调整的底层逻辑,彻底打通大模型架构的知识壁垒。
Transformer的诞生:为机器翻译而生的双向架构
2017年Transformer模型的诞生,彻底颠覆了传统NLP领域依赖循环神经网络的技术格局,其最初的设计目标非常纯粹,就是解决机器翻译任务的序列转换问题。机器翻译天然存在两个独立序列,分别是输入的源语言序列和输出的目标语言序列,这种输入输出分离的任务特性,决定了初代Transformer独一无二的双模块架构。
初代Transformer完整架构分为编码器和解码器两大板块,两大模块分工明确、各司其职,形成了先理解后生成的完整工作链路。编码器专门负责接收外部输入文本,完成语义理解、上下文特征提取,解码器则承接编码器的输出特征,结合已生成的文本内容,逐字逐句生成目标文本,完美适配机器翻译的序列映射需求。
我们可以用中英翻译的场景直观理解这套逻辑,当输入英文句子I love artificial intelligence,编码器会完整解析整句英文的语义、词汇关联、语序特征,完成对输入内容的深度理解,随后将提取的全局特征传递给解码器,解码器基于这些特征,逐步生成对应的中文翻译结果我喜欢人工智能。
这套编码器加解码器的双向架构,是Transformer最原始、最完整的形态,也是后续所有大模型架构迭代的基础。想要看懂后续的所有优化,首先要吃透两大核心模块的工作原理和核心差异。
编码器:全局无遮挡的语义理解核心
编码器的核心定位是语义理解,它的所有设计都是为了最大化提取输入文本的全局上下文特征,这也让它具备了和解码器完全不同的运算逻辑。
文本输入编码器的完整流程十分规整,原始文本首先经过词嵌入处理,将文字转化为模型可识别的Token向量,再叠加位置编码信息,弥补注意力机制无法识别语序的缺陷,最终形成包含语义和位置信息的完整输入向量。随后输入向量会逐层送入堆叠的编码器模块中完成特征迭代。
每一层编码器模块的核心结构由多头自注意力机制、残差连接、层归一化和前馈神经网络组成,运算流程固定为输入经过多头自注意力计算,完成文本内部词汇的关联建模,通过残差连接和层归一化优化梯度传播,最后送入前馈神经网络做特征非线性变换,再次归一化后输出至下一层。
编码器最核心的特性,也是它无需掩码机制的根本原因,就是全局可见的注意力机制。在处理任意一个词汇Token时,编码器可以同时看到输入序列中的所有内容,不存在未来信息遮挡的问题。
依旧以英文例句I love artificial intelligence为例,模型处理love这个单词时,能够直接关联前后所有词汇的信息,完整感知整句话的语义逻辑。因为编码器的任务是理解完整文本,输入序列从一开始就是完整固定的,不需要隐藏任何后续内容,这也是编码器自注意力矩阵为完整全连接矩阵的核心原因。
经过多层编码器迭代计算后,最终输出的不再是简单的词嵌入向量,而是每一个Token都融合了全文上下文信息的深度表征。此时每个词汇的向量信息,都承载了整句文本的语义、语序、关联关系,这份高质量的全局特征,就是后续解码器生成文本的核心依据。
解码器:带约束的序列生成核心
如果说编码器是静态的语义理解工具,解码器就是动态的文本生成工具。为了适配逐Token生成的任务特性,初代Transformer的解码器结构比编码器更复杂,额外增加了一组注意力机制,同时引入了核心的掩码约束。
解码器内部包含两套功能完全不同的注意力机制,分别是掩码多头自注意力和交叉注意力,两套机制分工配合,共同完成文本生成任务。
掩码多头自注意力是解码器实现自回归生成的核心。文本生成是一个逐字迭代的过程,模型每生成一个Token,都需要基于已有的文本预测下一个Token,绝对不能提前使用未生成的未来信息,否则会出现训练泄密的问题。
在翻译场景中,当解码器已经生成我喜欢这两个字时,模型只能基于现有内容预测下一个词汇,必须屏蔽后续人工智能的目标文本信息。掩码机制会通过矩阵遮挡,让每一个位置的Token只能关联自身及前方的内容,彻底杜绝未来信息泄露,保证训练逻辑的合理性。
这里需要厘清初学者最容易误解的Outputs shifted right机制,这是Transformer训练阶段的核心逻辑。在训练过程中,解码器不会让每个位置的Token预测自身,而是将目标序列整体右移一位。比如目标句子是我喜欢人工智能
解码器的第二套注意力机制交叉注意力,是原生Transformer架构的专属模块,也是连接编码器和解码器的核心桥梁。掩码自注意力只负责理解模型已经生成的目标序列,而交叉注意力的作用,是让生成过程始终关联原始输入文本,保证生成内容的准确性和关联性。
两者的核心区别在于信息来源,自注意力的查询、键、值矩阵均来自同一序列,要么是编码器的输入序列,要么是解码器的生成序列,实现序列内部的信息交互。而交叉注意力的查询矩阵来自解码器当前生成的序列,键和值矩阵则来自编码器输出的全局输入特征。
我们可以通俗理解交叉注意力的工作模式,模型每生成一段内容,就会拿着当前的生成特征作为查询,去编码器存储的全局输入信息中检索对应的内容,匹配相似度最高的特征,提取关键信息指导下一个Token的生成。在翻译场景下,就是解码器生成中文片段时,持续对标英文原句的语义特征,确保翻译结果精准贴合原文含义。
架构第一次蜕变:Decoder-only架构统一NLP任务
初代编码器加解码器的架构,在机器翻译任务中表现极佳,但在后续各类自然语言处理任务的落地中,逐渐暴露出局限性。随着NLP技术的发展,研究者发现几乎所有主流语言任务,都可以统一成前文预测后文的自回归生成形式,这也推动了Transformer架构的第一次关键迭代,Decoder-only纯解码器架构正式诞生。
无论是问答、文本摘要、机器翻译、代码生成,还是对话交互,看似场景截然不同,但底层任务逻辑高度统一。问答任务是基于问题文本生成答案,摘要任务是基于长文本生成精简摘要,编程任务是基于需求文本生成代码,所有任务都可以转化为给定上下文序列,预测后续文本的通用范式。
既然所有任务都能统一为自回归生成,独立的编码器模块就显得冗余且多余。编码器的核心作用是提取外部输入的全局特征,但在统一的生成任务中,所有输入提示、上下文信息,都可以直接融入解码器的输入序列中,无需单独的编码模块做特征提取。
基于这个核心逻辑,研究者彻底移除了独立编码器和专属的交叉注意力模块,只保留带有掩码自注意力的解码器核心结构,形成了极简的Decoder-only架构。这也是GPT、LLaMA、通义千问等现代大模型的基础骨架。
需要重点区分的是,Decoder-only架构并不是直接照搬初代Transformer的解码器模块,而是做了精简优化。初代解码器包含掩码自注意力、交叉注意力、前馈网络三层结构,移除交叉注意力后,现代大模型的基础模块简化为掩码因果自注意力加前馈网络的核心组合,通过多层堆叠形成完整模型架构。
这次架构蜕变带来的最大价值,是实现了NLP任务的全局统一。以往不同任务需要定制不同的模型架构和训练目标,而Decoder-only架构让所有语言任务共享同一套模型结构、同一套训练逻辑和同一套损失函数,为海量数据预训练、模型规模化扩容、指令微调、对话交互等后续技术突破奠定了核心基础。
现代大模型精细化迭代:五大核心模块升级
Decoder-only架构确立后,大模型的基础骨架就已经定型,但初代纯解码器架构仍存在训练不稳定、推理效率低、上下文长度有限、特征提取能力弱等诸多问题。近几年主流大模型的迭代升级,并没有颠覆Transformer的核心逻辑,而是在归一化方式、位置编码、激活函数、注意力机制、推理优化五大维度,完成了精细化的技术革新,让模型性能和效率实现质的飞跃。
归一化机制升级:从Post-Norm到Pre-Norm与RMSNorm
归一化是保证深层模型训练稳定的关键模块,初代Transformer采用的是Post-Norm后归一化模式,运算流程为先执行注意力机制和前馈网络计算,再做层归一化处理。这种结构在模型层数较浅时效果稳定,但当模型堆叠数十上百层后,梯度反向传播会出现衰减问题,导致深层模型难以收敛。
现代大模型全面改用Pre-Norm前归一化模式,将归一化操作前置,在每一层特征计算前先对输入向量做标准化处理。这种调整让残差主干链路更加简洁直接,梯度传播路径更稳定,能够完美适配超深层Transformer模型的训练需求,是千亿、万亿参数模型能够稳定训练的核心保障。
在归一化算法层面,主流模型也完成了从LayerNorm到RMSNorm的迭代。传统LayerNorm需要同时完成均值归零、方差缩放两步操作,计算成本较高。RMSNorm舍弃了均值中心化的冗余步骤,只保留尺度归一化核心逻辑,在保证模型性能基本不变的前提下,大幅降低计算开销,提升训练和推理速度,目前LLaMA、通义千问等主流开源、闭源模型均采用该算法。
位置编码升级:RoPE旋转位置编码成为主流
注意力机制本身无法识别文本语序,必须依靠位置编码为Token向量注入时序信息。初代Transformer使用的是绝对位置编码,直接将固定的位置向量与词嵌入向量叠加,这种方式简单直观,但存在明显短板,无法适配超长文本上下文,外推性极差。
现代大模型全面替换为RoPE旋转位置编码,彻底革新了位置信息的注入方式。RoPE不再直接叠加固定位置向量,而是通过矩阵旋转的数学运算,将位置信息融入注意力分数的计算过程中,让模型在计算Token关联度的同时,自动感知词汇的相对位置关系。
这种相对位置编码的设计,具备极强的上下文外推能力,能够支持数万甚至数十万长度的文本输入,完美适配长文本生成、长对话交互、长文档理解等场景,是当前所有高性能大模型的标配技术。
激活函数升级:SwiGLU替代传统ReLU架构
前馈网络的激活函数,直接决定模型的特征非线性变换能力。初代Transformer采用最基础的ReLU激活函数,结构简单但特征筛选能力有限,难以适配复杂的语义特征学习。
后续行业先迭代出GELU激活函数,在ReLU基础上优化了梯度拟合效果,而现代主流大模型进一步升级为SwiGLU激活函数。SwiGLU通过双线性门控结构,引入动态特征筛选机制,能够自主判断哪些特征需要保留、哪些冗余特征需要抑制,大幅提升模型的特征提取和表达能力。
相较于初代简单的线性加激活函数结构,SwiGLU加持的前馈网络具备更强的非线性建模能力,让大模型能够精准捕捉复杂的语言逻辑、语义关联,是模型理解和生成高质量文本的关键优化。
注意力机制轻量化:MHA迭代为GQA混合注意力
多头注意力机制是Transformer信息交互的核心,但标准多头注意力MHA在大模型推理阶段存在严重的显存和算力浪费。MHA架构中,每一个查询头都对应一组独立的键值头,模型头数越多,键值矩阵的参数量和缓存占用就越大,上下文长度越长,显存带宽的压力就越明显,严重限制大模型的推理速度。
为解决这一痛点,GQA混合查询注意力机制应运而生,成为现代大模型的核心优化方案。GQA的核心逻辑是多查询头共享一组键值头,在保留多视角查询建模能力、保证模型精度基本不变的前提下,大幅削减键值矩阵的参数量和缓存占用,有效降低显存消耗和计算开销,完美平衡模型性能与推理效率。
推理工程优化:KV Cache与FlashAttention落地
除了模型结构的算法优化,现代大模型的高效运行,离不开两大核心工程优化技术,分别是KV Cache缓存机制和FlashAttention高效计算,这两项技术不属于模型结构创新,却是大模型能够落地商用的关键支撑。
KV Cache是针对自回归生成的增量优化技术。大模型逐Token生成文本时,历史Token的键值矩阵经过一次计算后就不会改变,传统推理模式会重复计算所有历史Token的键值信息,造成大量算力浪费。KV Cache会将已经计算完成的键值矩阵缓存保存,后续生成新Token时,仅需计算新增内容的键值信息,与历史缓存数据完成注意力计算,将重复计算转化为增量计算,推理速度可提升数倍甚至数十倍。
FlashAttention则是从硬件适配角度优化注意力计算效率,通过精细化的分块计算、内存调度和中间存储优化,减少GPU显存与片上内存之间的数据搬运开销,充分释放GPU的算力潜力。它没有改变注意力机制的数学计算逻辑,只是优化了硬件执行效率,让超大上下文、超大参数量模型的高效训练和推理成为可能。
Transformer家族完整谱系:三类架构的分工与定位
梳理完核心演化路径后,我们可以完整定义Transformer的三大分支架构,彻底厘清不同模型的定位和适用场景,避免认知混淆。
第一类是编码器独享架构,以BERT为典型代表。该架构仅保留双向编码器模块,依靠全局可见的注意力机制,擅长提取文本的全局语义特征,主要用于文本分类、信息抽取、语义匹配、情感分析等理解类NLP任务,核心优势是语义表征精准,缺陷是无法完成文本生成。
第二类是编码器加解码器的Seq2Seq架构,以初代Transformer、T5等模型为代表。双向模块搭配的结构,兼顾语义理解和序列生成能力,专门适配机器翻译、文本改写、摘要生成等序列转换任务,是传统结构化NLP任务的主流架构。
第三类是解码器独享架构,也就是现代通用大模型的核心架构,以GPT、LLaMA、通义千问为代表。该架构通过统一的自回归生成范式,兼容所有NLP任务场景,既能完成语义理解,也能实现文本、代码、对话等各类内容生成,具备极强的通用性和扩展性,这也是它最终成为通用大模型主流架构的核心原因。
架构演化的终极逻辑:不变的核心,迭代的优化
从2017年初代Transformer诞生,到如今千亿参数通用大模型遍地开花,八年的技术迭代看似改动繁多,但底层核心从未改变。所有现代大模型的骨架,始终保留着注意力机制加前馈网络的核心组合,注意力机制负责序列内部的信息交互、关联建模,前馈网络负责特征的非线性加工与升级,这两个基础模块,是整个Transformer体系的底层基石。
所有的架构迭代和技术优化,本质上都是在解决三个核心问题,一是让模型训练更加稳定,能够支撑更大参数、更深层数的模型搭建。二是让模型推理更加高效,降低算力和显存消耗,适配商用落地场景。三是让模型适配更长上下文、更多复杂任务,提升通用智能能力。
初代Transformer解决了完全基于注意力机制实现序列建模的核心问题,打破了循环神经网络的时序限制。Decoder-only架构解决了多任务统一建模的问题,让通用人工智能成为可能。而后续的归一化、位置编码、注意力机制、工程优化,都是在持续打磨模型的性能上限,让Transformer架构能够适配海量数据、超大模型、复杂交互的现代AI场景。
很多人会纠结不同架构的优劣、不同参数的差异,但真正的技术核心从来不是单一模块的创新,而是持续迭代的演化思维。现代大模型不是凭空诞生的新技术,而是初代Transformer在任务逻辑、结构设计、工程落地等多个维度,持续优化、层层迭代的最终成果。
看懂这条完整的演化链路,就能跳出碎片化的知识点,真正理解大模型的底层工作逻辑,也能清晰预判未来大模型的迭代方向,所有后续创新,依然会围绕稳定训练、提升效率、增强通用能力三大核心方向持续推进。

发表评论 取消回复