Context is all you need:Context 用对了,Agent 办公才高效
面向 AI Agent 的上下文数据库。用一个文件系统组织知识、记忆和技能,做 Agent Native 团队的第二大脑。
过去半年一直在用 Agent 伴随办公,昨天让他帮我准备项目进展报告,感觉不对劲。
-
项目预算还是三个月前的数字,上周改过,Agent 没更新记忆。
-
技术方案引用错了。两个项目都有一份《技术方案》,它拿的是另一个项目的。
-
为了确认一个里程碑日期,它把几十份文档从头读了一遍。这些文档上周它刚看过,这次又全部重看,等了好几分钟,token 也花了不少。
最后只能自己逐条核对,用了 Agent,活反而更多了
用 Agent 干过活的人,多半碰到过类似的事。我们经常说 Agent 笨,但是其实模型错是因为缺了一套管理历史记忆的办法。
过去几个月,OpenViking 团队围绕 怎么记?怎么存?怎么找?这三个问题做了三项研究:
问题
怎么记
研究
VikingMem(VLDB 收录)
链接
VikingMem: A Memory Base Management System for Stateful LLM-based Applications
问题
怎么找
研究
TrieHI(ICDE 收录)
链接
Directory-Aware Query and Maintenance in Vector Databases
问题
怎么读
研究
VikingRAG
链接
VikingRAG: Accurate and Token-efficient Retrieval-augmented Generation over Structured Documents
一、【怎么记】VikingMem:记多不是重点,重点是记得对
-
VikingMem: A Memory Base Management System for Stateful LLM-based Applications
-
https://arxiv.org/abs/2605.29640
Agent 为什么会记错预算?
Agent 并不是没记住上周的修改,问题是它记得太多。新和旧内容都在记忆里,查询时都被搜出来,但又不知道该信哪条。大多数 Agent 的记忆系统大多是一个只进不出的收藏夹,说过的话按时间一条条存进去,用的时候按字面相关性捞出来。你用得越久,记忆内重复、过时、互相矛盾的内容也越来越多。
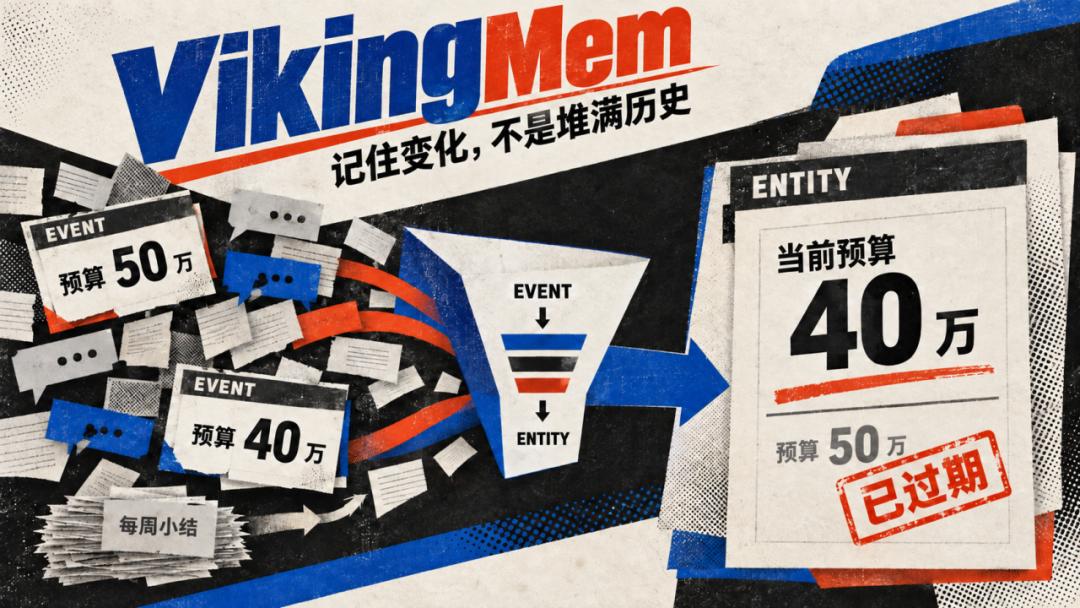
VikingMem 把记忆当成一份持续更新的档案。每来一条新信息,系统先判断三件事:值不值得记?说的是哪件事?有没有改变这件事现在的情况?
一本日记,一份档案
VikingMem 把记忆分成两层。
-
事件(Event) 像日记,记下某件事什么时候发生了什么。
例子:两条独立 Event:三个月前定的"预算 50 万",上周"改成 40 万"
-
实体(Entity) 像档案,从日记里整理出每件事现在的样子,由一组算子按需调用大模型维护
例子:最新预算档案:"项目当前预算 40 万" 是把两条合起来之后的 Entity。
在维护档案时,可以决定是否需要调用大模型:能直接算的就直接算(比如次数、总数)用加法计数就行,只有需要理解意思的合并和冲突判断,才交给大模型处理。
把聊散的同一件事拼回来
我们跟 Agent 聊天不会按主题来。比如先说预算要砍一点,中间插一句 B 项目的上线时间,聊了几轮别的,又回来说"预算那个就定 40 万吧"。如果一句一句地存,Agent 很难把它们对上。
VikingMem 会先去掉闲聊,再把散在多轮对话里的同一件事合成一条完整记录。这一步在写入时就做完了,查询时不用额外等。我们通过测试发现这一步的重要性:去掉这一步,LoCoMo 长期记忆评测的得分从 88.83 掉到 83.51,是所有环节里影响最大的。
旧事衰减
最近的事保留细节,很久没人提的旧事压缩成类似周报、月报的摘要。来龙去脉还在,但不用每次都整段交给模型。
实验效果
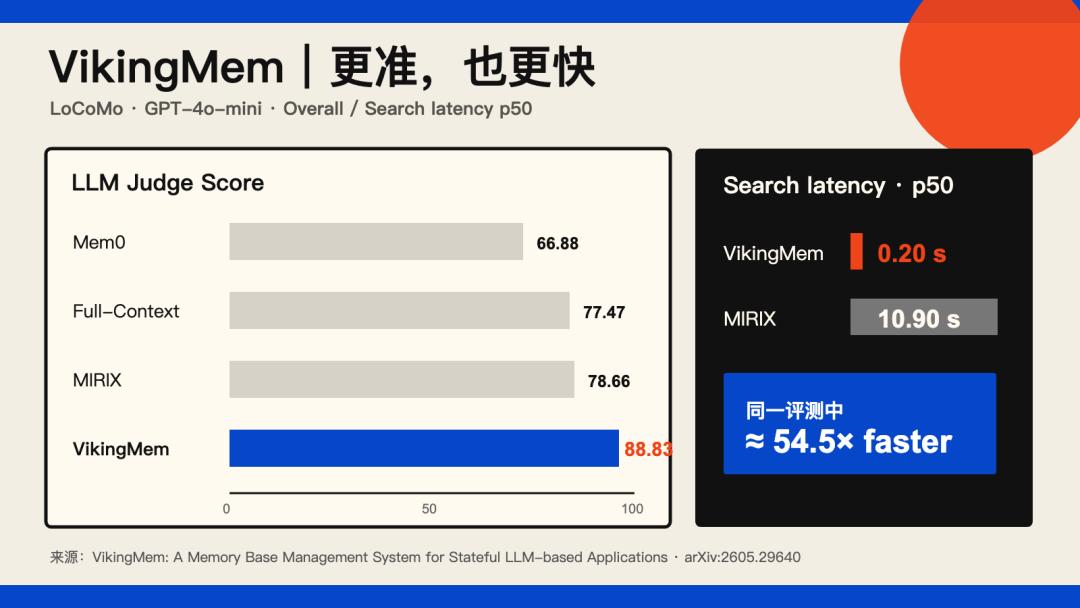
准确性:在 LoCoMo 长期记忆评测上,VikingMem 得 88.83,第二名 MIRIX 是 78.66。把全部聊天历史直接塞给模型只有 77.47:信息最全,分数反而更低,因为无关内容太多,模型会被带偏。
速度:VikingMem 一次查询一般在 0.2 秒左右,分数最接近的 MIRIX 要 10 秒以上。
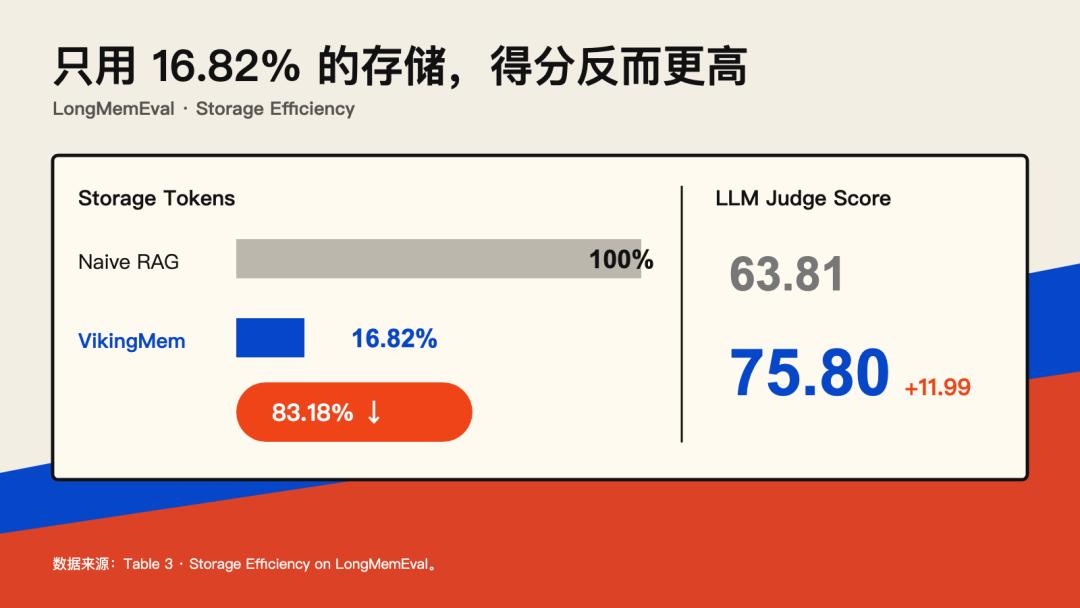
存储:只存事件和实体,占的空间大约是原始记录的六分之一。利用 VikingMem 后,得分比普通的检索方案高。LongMemEval 评测,75.80 vs 63.81(+11.99 pp)。
技术细节
-
搜索结果会再做一轮多向量精排(ColBERT 式)。向量在写入时就算好并压缩,精排耗时在百毫秒级。
-
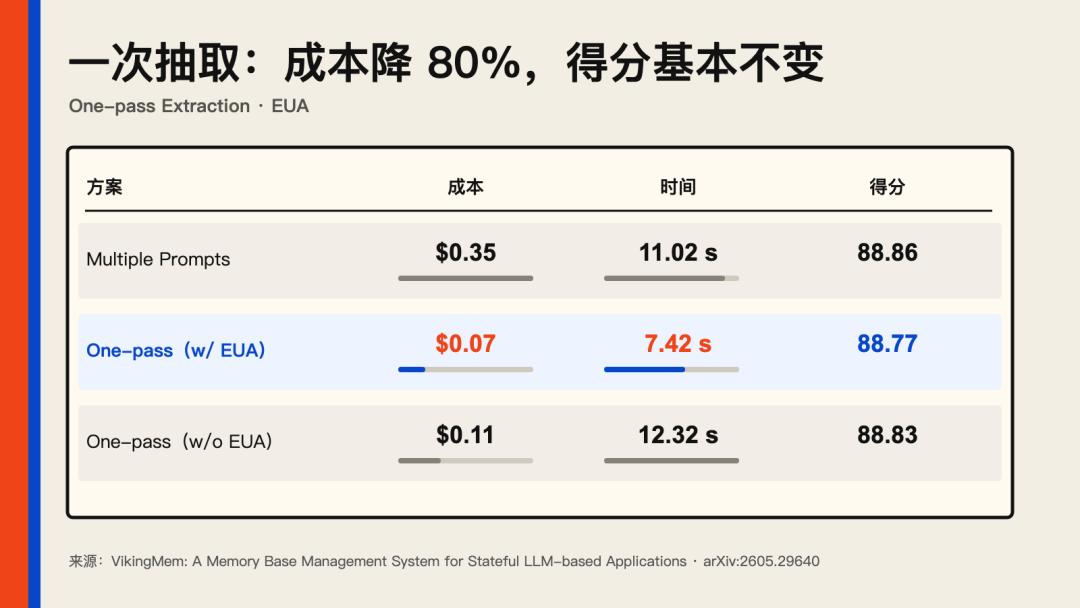
所有记忆类型写在同一个提示词里,一次抽完。
-
更新档案时,模型只输出一改动;通过找到旧文字,替换成新文字。系统按编辑距离定位旧内容,原地替换,不用再调一次模型。在得分基本不变的情况下,单次抽取成本从 0.35 美元降到 0.07 美元。
这套 Event / Entity 记忆方案已经在 100+ 个真实企业应用上线,覆盖教育、Agent 记忆和陪伴类场景。
二、【怎么存】TrieHI:为什么 OpenViking 做成了一个文件系统
-
Directory-Aware Query and Maintenance in Vector Databases
-
https://arxiv.org/abs/2606.16903
Agent 为什么会拿错文档
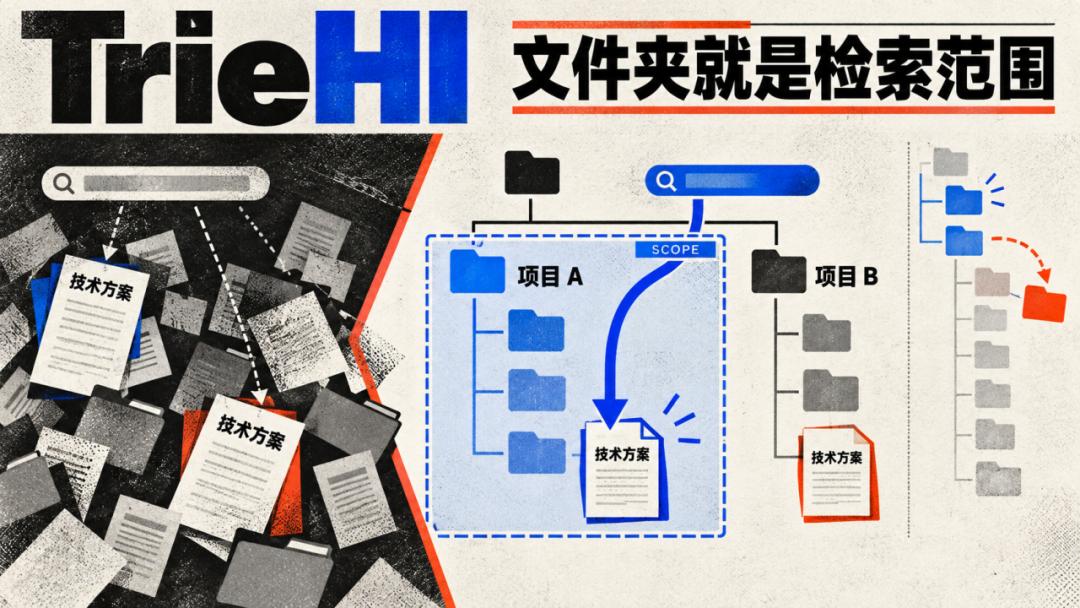
两个项目的《技术方案》,标题一样,结构也差不多,都是背景、架构、排期。只看内容像不像,这两份几乎分不开。因为向量搜索没有文件夹的概念,所有资料放在一个空间内。搜索时,只能按内容相似度召回。最多在召回后的重排阶段再按标签、关键词筛一下。
例如:search "技术方案" --tag=项目A --keyword="架构"
思路简单,难在数据库这一层
我们在整理资料时,经常也会按项目建文件夹来管理内容。由于向量数据库原本不认识文件夹,路径只是一段文字,所以如果你想通过向量搜索来限制搜索目录,没有 TrieHI 之前,这个方案有两个大问题:
-
标签要有人提前打好,漏打一个,结果就偏了。
-
相似的资料太多,条件稍微宽一点,别的项目的文档就混进来了。
TrieHI 的思路也一样,把内容整理到目录内,搜的时候先指定文件夹,但是我们针对这种场景做到的显著的优化。
TrieHI 做了什么
我们的目标是要让系统能够快速的完成 "只在这个文件夹和子文件夹里搜" 的操作,并且也能应付用户移动、合并文件夹等操作。
TrieHI 把目录按原样存成一棵树,每个文件夹上挂一张清单,记着这个文件夹和它下面所有子文件夹里有哪些资料。
-
搜索时:找到目标文件夹,直接拿这张清单,只在清单内的候选中做向量检索。
-
移动文件时:把整个分支挪到新位置,只更新沿路几个上级文件夹的清单,下面的资料一份都不用改。
实验效果
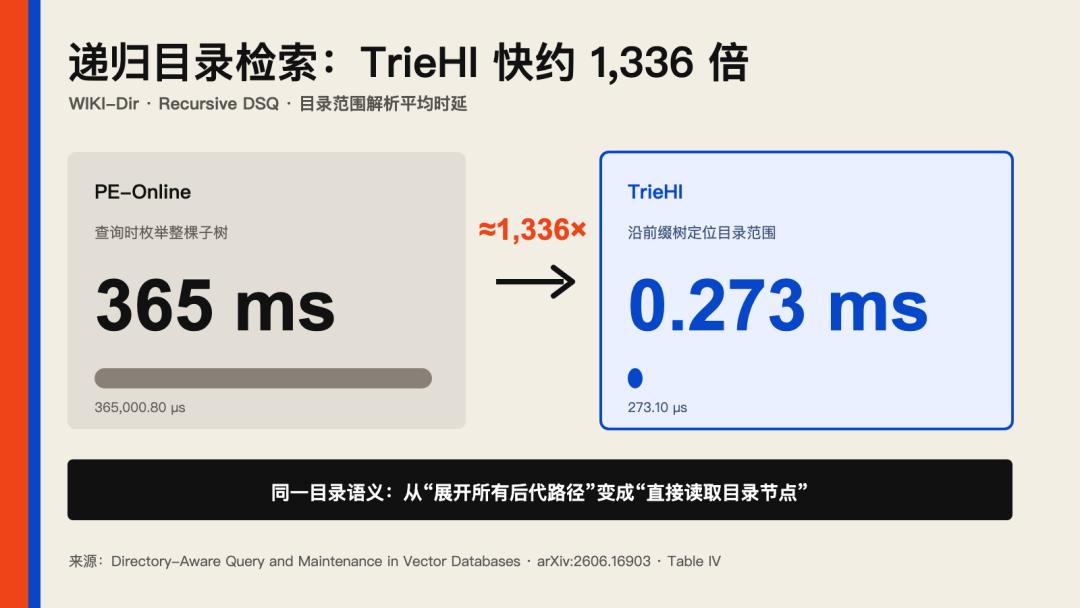
利用TrieHi来确定一个大文件夹下有哪些资料,耗时从 365 毫秒降到 273 微秒,查询速度快了一千多倍。
OpenViking 内怎么按文件夹找
我们在整理资料时,经常也会按项目建文件夹来管理内容。OpenViking 用的是同一个办法。资料、记忆、技能都放在 viking:// 开头的目录里,搜的时候先指定文件夹:
代码块:
ov find viking://projects/项目A "技术方案"ov find viking://projects/项目B "技术方案"Agent 在使用 OpenViking 时,先看看有哪些文件夹、各叫什么,再自己决定进哪一层去找。在一个文件夹下同样搜 "技术方案",因为另一个项目的同名文件根本不在搜索范围里,搜索只会拿到指定项目的文档,不再搞混。
文件夹不只是摆给人看的,是允许Agent在搜索时按它来划搜索范围。
三、【怎么找】VikingRAG:缺什么数据,就去找什么
-
VikingRAG: Accurate and Token-efficient Retrieval-augmented Generation over Structured Documents
-
https://arxiv.org/abs/2609.11390
Agent 为什么要把几十份文档读一遍
回到里程碑日期的场景,答案可能就在某份排期文档的某一节里。因为 Agent 不知道大概在哪,最稳妥的办法就是全读一遍。这样又慢,又费 token,而且还会被无关内容给带偏。
人查资料习惯和 Agent 默认的习惯不一样:我们会先看目录,找到大概位置,再翻到那一节细读。读到的信息够了就停,不够再去别处找。VikingRAG 让 Agent 也和人一样的查资料。
先看简介,再往下读 (VikingRAG)
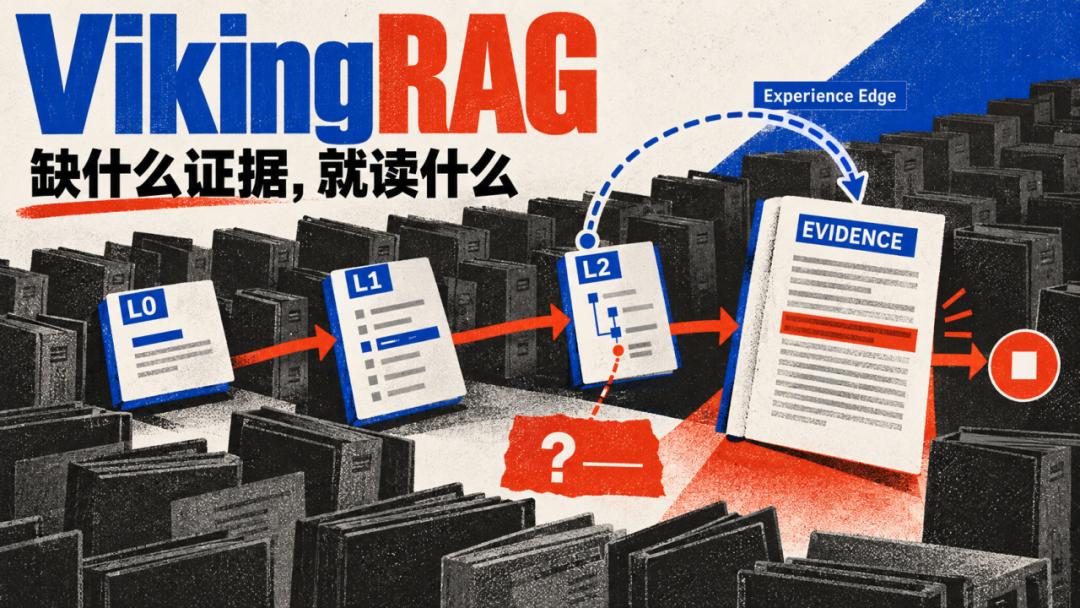
在 OpenViking 里,每个文件夹、每份文档都准备了三种读法:
-
L0:一句话简介,判断和问题有没有关系
-
L1:目录和概要,告诉 Agent 下一步往哪走
-
L2:完整原文
通过VikingRAG,Agent 可以完整的模拟人的查询习惯 —— 先看简介,确认方向后一层层往下读,按需阅读原文。每读完一段,Agent 也会检查证据够不够,如果已经有足够讯息,Agent 也会停止查询,回答问题。
记住上次是怎么找到的(VikingRAG-E)
如果你的团队的新同事刚接手项目:
-
第一次有人问里程碑,他得从项目根目录一层层翻,最后在《项目排期》第三节找到。
-
第二次再有人问,他直接打开《项目排期》翻到第三节
VikingRAG-E(VikingRAG 的增强版)让 Agent 也能这样。
VikingRAG-E 会把之前的查找路线存下来:当时问的是什么,从哪开始找,最后在哪找到的。下次遇到相似的问题,直接顺着这条路线(Experience Edge)把上次找到的内容带出来,不用从头翻。
Experience Edge 和知识图谱有显著的差异:
-
知识图谱 记的是 "A 和 B 有什么关系"
-
Exprience Edge 记的是 "上次问这类问题,最后是在这儿找到的"
简单问题不走复杂流程(VikingRAG-E+)
我们也在 VikingRAG-E 的基础上加了自适应的升级。VikingRAG-E+ 会先做一次快速查找,检查找到的内容够不够回答。如果判断内容已经足够回答问题,就会直接触发回答,只有在内容不够时才进入完整的多轮查找。
实验效果
在六个结构化文档数据集上,准确率基本持平的情况下:
-
VikingRAG 用的 token 只有高准确率方法的 11.6%–51.9%
-
加上记住路线和先快后全,降到 5.1%–32.5%
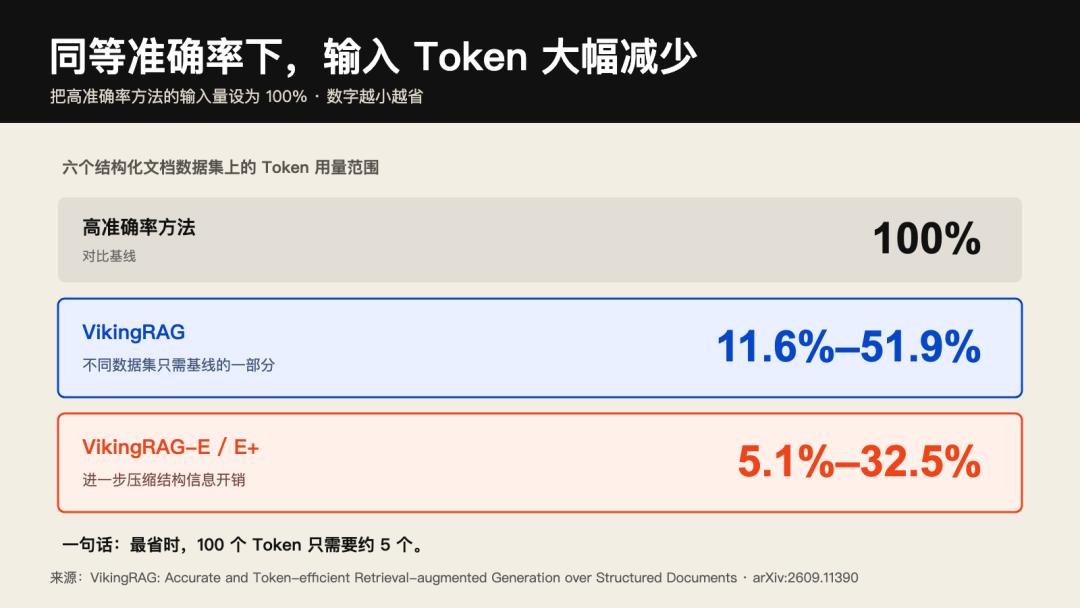
目前的方案也有短板:判断 "数据足够,可以停了" 在多个数据集上仍有超过 5% 的误判
目前 L0 / L1 / L2 分层,按需读取,经验记忆已经在 OpenViking 里上线。自动先快后全检索还在实验阶段。
四、用上 OpenViking 之后
三项能力合在一起是什么效果?
把OpenClaw、Hermes、Claude Code 接上 OpenViking
-
在 LoCoMo 长期记忆评测上,问答准确率从 24%–57% 升到 80%–83%,查询时间和输入 token 同时下降。
-
在 HotpotQA 多步问答上,OpenViking 准确率 91%,每题约 1.25 万 token,检索 0.23 秒(同一实验里 LightRAG 是 89%、约 2.8 万 token、75 秒)。
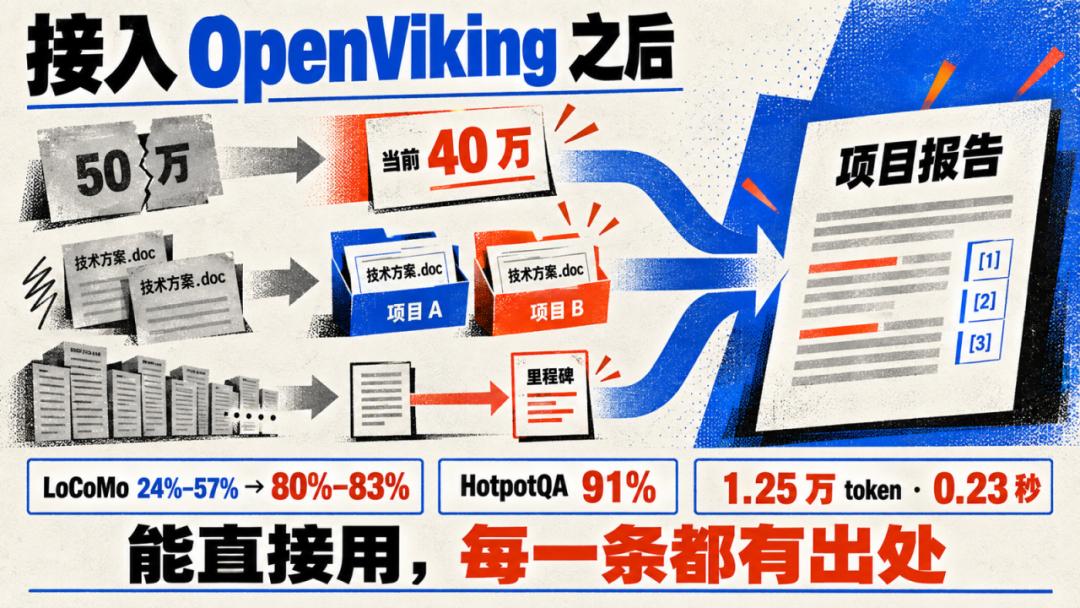
如果那天我的 Agent 接了 OpenViking
-
预算:它知道上周的修改覆盖了三个月前的数字。旧数字还在,但标着已过期。
-
技术方案:它先确认周报说的是哪个项目,只在这个项目的文件夹里找。
-
里程碑:它先看简介和目录,直接翻到排期那一节。上周找过的路线还在,这次不用从头找。
我拿到的会是一份能直接用、每一条都查得到出处的材料。
五、试试 OpenViking | 让已有的 Context 成为下一次工作的起点
资料变化快?在多个对话、多个 Agent 之间接力?单个 Agent 自己的记忆已经撑不住了!
你的团队需要一个共用的第二大脑,OpenViking
上手试用,前 50 文档免费:
volcengine.com/product/openviking-service
开源 OpenViking:访问GitHub
(
https://github.com/volcengine/OpenViking) 仓库,为我们点亮一颗 Star!
❓ 三分钟测出你是哪种 Agent 饲养员选择属于你的 OpenViking:
https://blog.openviking.ai/post/should-you-use-openviking/

发表评论 取消回复